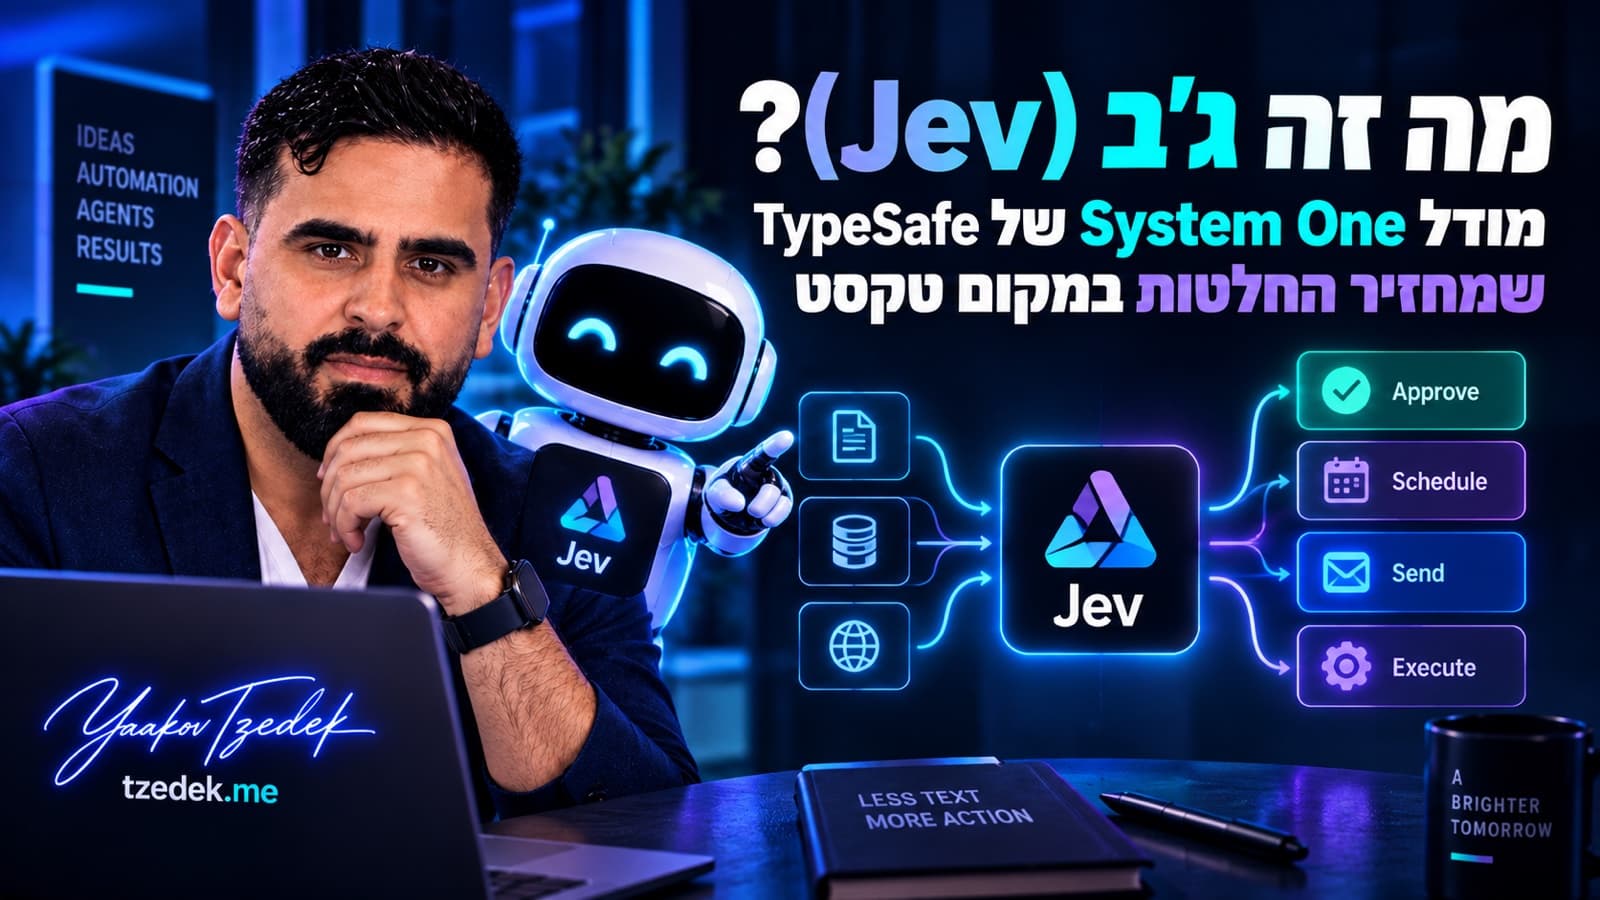
- מה זה: מודל מסוג חדש, "System One", שמחזיר החלטות מוקלדות (בחירה מרשימה, ניקוד בסולם, כן או לא) במקום טקסט חופשי.
- למה זה שונה: במקום לייצר טוקן אחרי טוקן, הוא דוגם את כל התשובות במעבר מקבילי אחד. לכן הוא מהיר פי 40 עד 200 ממודלי חזית, ולפי TypeSafe זול פי מאות.
- מה מקבלים: תשובה שתמיד תקינה מבחינת מבנה, הסתברות לכל אפשרות, וציון ביטחון שאפשר לנתב לפיו: לפעול, לבדוק, או להעביר לאדם.
השם ג'ב הוא קיצור של ג'בונס (William Stanley Jevons), הכלכלן הבריטי שהבחין במאה ה-19 שכשמנוע הקיטור נעשה יעיל יותר, צריכת הפחם דווקא עלתה, כי פתאום השתלם להשתמש בו בכל מקום. TypeSafe מהמרת שאותו דבר יקרה לאינטליגנציה: כשהחלטה עולה אלפית סנט, מכניסים AI לכל תנאי בתוכנה.
ג'ב (Jev) הוא מודל בינה מלאכותית שלא כותב טקסט. הוא מקבל מהתוכנה שלכם מצב (פנייה של לקוח, מסמך, רשומה) ורשימת שאלות סגורות, ומחזיר לכל שאלה תשובה מתוך האפשרויות שהגדרתם, עם הסתברות ורמת ביטחון, תוך פחות מחצי שנייה. את המודל שחררה ב-15.9.2026 חברת TypeSafe AI, שבראשה עומד דיוגו אלמיידה (Diogo Almeida), חוקר לשעבר ב-OpenAI ואחד הממציאים של שיטת האימון שהולידה את ChatGPT. המחיר: 0.042 דולר למיליון טוקני קלט, ופלט בחינם. זה בכלל לא החלק המעניין. החלק המעניין הוא הטענה שמאחורי המוצר: רוב מה שאנחנו מבקשים היום ממודלי שפה בתוך תוכנה הוא בכלל לא כתיבה. זה החלטות.
בקצרה
- מה זה: מודל מסוג חדש, "System One", שמחזיר החלטות מוקלדות (בחירה מרשימה, ניקוד בסולם, כן או לא) במקום טקסט חופשי.
- למה זה שונה: במקום לייצר טוקן אחרי טוקן, הוא דוגם את כל התשובות במעבר מקבילי אחד. לכן הוא מהיר פי 40 עד 200 ממודלי חזית, ולפי TypeSafe זול פי מאות.
- מה מקבלים: תשובה שתמיד תקינה מבחינת מבנה, הסתברות לכל אפשרות, וציון ביטחון שאפשר לנתב לפיו: לפעול, לבדוק, או להעביר לאדם.
- מה לא מקבלים: הסבר, ניסוח, קוד, חישוב. ג'ב לא כותב, וגם לא סופר ולא משווה תאריכים.
- למי: למי שבונה תוכנה עם AI בפנים: ניתוב פניות, סיווג, ניקוד, בדיקות בטיחות, בחירת כלים לסוכנים.
מה זה מודל System One?
הגדרה: מודל System One הוא מודל AI שנועד לקבל החלטות מהירות ומובנות שתוכנה יכולה להשתמש בהן ישירות. הוא מקבל "מצב" (state) וקבוצת שאלות מוקלדות, ומחזיר תשובות מתוך מרחב אפשרויות שהוגדר מראש, עם הסתברות מכוילת לכל אפשרות. הוא לא מייצר טקסט, לא כותב קוד ולא מסביר את עצמו.
השם לקוח מספרו של הפסיכולוג וחתן פרס נובל דניאל כהנמן, "לחשוב מהר, לחשוב לאט": מערכת 1 היא החשיבה המהירה והאינטואיטיבית, ומערכת 2 היא החשיבה האיטית והמכוונת. מודלי השפה של היום, עם שרשראות ההיגיון שלהם שנמשכות שניות ולפעמים דקות, חיים במערכת 2. הטענה של TypeSafe פשוטה: כשתוכנה צריכה להחליט לאיזו מחלקה לנתב פנייה, האם תגובה היא ספאם, או איזה כלי סוכן צריך להפעיל עכשיו, היא לא צריכה מסה. היא צריכה תשובה מהירה ואמינה, עם מספר שאומר כמה לסמוך עליה.
כדי להבין את ההבדל, שווה לראות איך זה נראה בפועל. שולחים למודל את הפנייה של הלקוח, ומקבלים בחזרה משהו כזה:
{
  "department": { "choice": "technical", "confidence": 0.78 },
  "frustration": { "score": 1.0, "confidence": 1.0 },
  "is_urgent": { "noul": 1.0 }
}
אין כאן פסקה לפרסר, אין "בטח, הנה הסיווג שביקשת", ואין סיכוי שהמודל ימציא מחלקה רביעית שלא קיימת אצלכם. יש שלוש תשובות, שלושה מספרים, וקוד שממשיך הלאה.
מי עומד מאחורי TypeSafe, ולמה זה חשוב
TypeSafe AI היא סטארטאפ שגייס לפי דיווח של האתר הטכנולוגי הבריטי The Register כ-40 מיליון דולר. המייסד והמנכ"ל, דיוגו אלמיידה, היה חוקר ב-OpenAI ונמנה עם ממציאי RLHF, שיטת האימון על בסיס משוב אנושי שהפכה מודל שפה גולמי ל-ChatGPT. זה פרט שחשוב להכיר, כי הבשורה של ג'ב היא בעצם ויכוח עם השיטה שהוא עצמו עזר להמציא.
הטיעון של אלמיידה, כפי שהוא מופיע בפוסט ההשקה, הולך כך: RLHF מאמן מודל לכתוב טקסט שבני אדם מעדיפים. RLVR, השיטה החדשה יותר, מאמן מודל לפתור בעיות שאפשר לאמת בתוכנה. שתיהן מייצרות מודלים שמדברים. אבל תוכנה לא צריכה שידברו איתה. היא צריכה ערכים מוקלדים והסתברויות כנות. לכן TypeSafe פיתחה שיטת אימון שלישית, שהיא קוראת לה RLCD: למידת חיזוק להחלטות מכוילות (Reinforcement Learning for Calibrated Decisions). המטרה שלה היא לא טקסט יפה, אלא הסתברות שבאמת משקפת את הסיכוי לטעות.
 האתר הרשמי של TypeSafe AI, צולם ב-20.9.2026. קרדיט: TypeSafe AI
איך ג'ב עובד: שלושה סוגי שאלות
כל קריאה לג'ב מורכבת משני חלקים: מצב (state), שהוא התוכן שרוצים לשפוט, ושאלות (questions), שהן השיפוטים שרוצים לקבל. המצב יכול להיות מחרוזת, אובייקט JSON או מערך של הודעות. השאלות הן משלושה סוגים בלבד, ואלה כל אבני הבניין שיש:
| סוג | מה שואלים | מה חוזר |
|---|---|---|
| Choice (בחירה) | איזו אפשרות מתוך רשימה סגורה | האפשרות שנבחרה, הסתברות לכל אפשרות, וביטחון |
| Score (ניקוד) | איפה על סולם מדורג עם תיאור לכל רמה | הציון, הסתברות לכל רמה, וביטחון |
| Noul (כן או לא) | האם טענה נכונה | הסתברות בין 0 ל-1 שהתשובה היא כן |
השם Noul הוא מילה שהמציאו ב-TypeSafe לשאלת כן/לא שמחזירה הסתברות, כדי שלא יתבלבלו עם בוליאני רגיל. בהמשך המדריך נקרא לה פשוט "שאלת כן/לא".
הנה קריאה מלאה, לקוחה מהמדריך המהיר של TypeSafe, ומתורגמת בהסברים בלבד (ההנחיות עצמן נשארות באנגלית, ותכף נסביר למה):
{
  "model": "jev-latest",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": ["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
שלושה דברים חשוב לשים לב אליהם:
1. השאלות עצמאיות. כל שאלה נשפטת בנפרד. אם תוסיפו שאלה רביעית, התשובות לשלוש הראשונות לא ישתנו. זה מאפשר לשלוח עשרות שאלות בקריאה אחת, במקביל, כמעט בלי תוספת עלות. TypeSafe קוראת לזה fan-out, ובספר המתכונים שלה יש דוגמה של תדריך רגולטורי ב-13 שאלות שרץ פי 10 מהר יותר ופי 12 זול יותר מאשר 13 קריאות נפרדות.
2. אין פרסינג. התשובה של department תהיה אחת משלוש המחרוזות שהגדרתם. לא "Technical support", לא "technical (probably)", ולא JSON שבור. TypeSafe מתארת את זה כ"שגיאת טיפוס בלתי אפשרית מתמטית", וזה נכון, כי המודל פשוט לא מסוגל להוציא משהו אחר.
3. ההסתברות היא המוצר. מודלי שפה ידועים לשמצה בביטחון עצמי מופרז, גם כשמבקשים מהם במפורש "תן הסתברות". ג'ב אומן כך שההסתברות תהיה כנה: אם הוא אומר 0.6, בערך 60 אחוז מהמקרים הדומים אכן נכונים. וזה מה שמאפשר את הטריק החשוב ביותר, שמגיע בהמשך: ניתוב לפי ביטחון.
הסתברות מול ביטחון: ההבדל שקובע מה הקוד עושה
TypeSafe מפרידה בין שני מספרים, וההפרדה הזאת היא לב השיטה:
- הסתברות היא ההתפלגות בין האפשרויות. לשאלת בחירה עם שלוש אפשרויות, למשל 90/6/4.
- ביטחון (confidence) הוא מספר יחיד בין 0 ל-1 שנגזר מצורת ההתפלגות: כמה היא מרוכזת באפשרות אחת. התפלגות 90/6/4 נותנת ביטחון של בערך 0.7. התפלגות 40/33/27 נותנת 0.4. ושלוש אפשרויות שוות לגמרי נותנות 0.
הביטחון לא אומר לכם מה התשובה. הוא אומר לכם אם לפעול לפיה. התיעוד ממליץ על שלוש מדרגות:
| ביטחון | מה הקוד עושה |
|---|---|
| מעל 0.9 | פועל אוטומטית |
| 0.5 עד 0.9 | פועל בזהירות: מאמת, מבקש אישור, או שולח למודל שפה יקר יותר |
| מתחת ל-0.5 | מעביר לאדם |
והמדרגות אמורות להשתנות לפי המחיר של טעות. פעולת קריאה בלבד? אפשר לפעול גם ב-0.7. העברת כספים? רק מעל 0.9, ומתחת ל-0.5 תמיד לאדם, גם אם "בסך הכול" המודל צודק. זו הגישה שהופכת מודל AI מקופסה שחורה לרכיב שאפשר לכתוב עליו בדיקות ולהגדיר לו מדיניות.
מהירות, מחיר ודיוק: המספרים, ומי מדד אותם
כאן חשוב לדייק: כל המספרים בסעיף הזה הם מדידות של TypeSafe עצמה, על תהליכי עבודה שהיא בחרה, ונכון ל-20.9.2026 אין עדיין שחזור בלתי תלוי. עם הסתייגות זו, הנה מה שהחברה מפרסמת.
מהירות. זמן תגובה של 70 עד 500 אלפיות שנייה לשאילתה, לעומת 3 עד 329 שניות למודלי חזית עם היגיון. בהדגמה שצוטטה ב-The Register: 0.114 שניות מול 8.566 שניות ל-GPT-5.6 Terra על אותה משימה.
מחיר. 0.042 דולר למיליון טוקני קלט, ופלט חינם. מודלי החזית של OpenAI ואנתרופיק נעים בין 0.2 ל-10 דולר למיליון טוקני קלט, והפלט אצלם יקר פי כמה. TypeSafe מחשבת שסריקה של 50 מיליון שורות עולה אצלה בערך 20 דולר, לעומת אלפי דולרים במודל שמחויב על פלט.
דיוק. על ארבעה תהליכי עבודה (תגובה לאירוע אבטחה, ניטור מערכות, עיבוד חשבוניות ושירות לקוחות), TypeSafe מדווחת:
| מודל | דיוק | עלות למקרה | זמן |
|---|---|---|---|
| ג'ב (Jev) | 67.8% | 0.0004 דולר | 0.4 שניות |
| GPT-5.6 Terra | 67.9% | 0.0304 דולר | 10.1 שניות |
| GPT-5.6 Sol | 74.1% | 0.0836 דולר | 23.3 שניות |
| Claude Opus 5 | 73.1% | 0.1761 דולר | 37.8 שניות |
התמונה הכנה: ג'ב משיג את הדיוק של המודל הבינוני של OpenAI בכ-1/76 מהמחיר ופי 25 מהר יותר, אבל המודלים החזקים ביותר עדיין מדויקים ממנו ב-5 עד 6 נקודות. בנוסף, TypeSafe מדווחת על 0 אחוז שגיאות פלט מובנה, לעומת 0.58 אחוז ל-Terra, 5.73 אחוז ל-Claude Opus 5, ו-45.5 אחוז ל-Claude Haiku 4.5, ועל 0 אחוז שגיאות בקריאות כלים לעומת 17 אחוז ל-GPT-5.6 Sol. המספרים האלה מרשימים, אבל יש בהם עיוות מובנה שכדאי לזכור: ג'ב לא יכול לטעות במבנה, כי אין לו מבנה לטעות בו. ההשוואה הרלוונטית היא רק על "האם בחר נכון", לא על "האם החזיר JSON תקין".
ההדגמה שכולם דיברו עליה: בוט שמשחק Doom
לצד המספרים, TypeSafe הראתה שני דברים שקל להבין. הראשון: בוט שמשחק במשחק המחשב הקלאסי Doom בזמן אמת, בערך 10 שאילתות בשנייה, בעלות של כ-7 דולר לשעה. המודל מקבל את מצב המשחק כטקסט ומחזיר את הפעולה הבאה. אף מודל שפה לא היה עומד בקצב הזה. השני: משחק Wikiracing, מרוץ בין ערכי ויקיפדיה דרך קישורים, שמדגים בחירה מתוך רשימות גדולות. ג'ב תומך בעד 255 אפשרויות בשאלת בחירה אחת.
איך מתחילים: API, SDK וסקיל לקלוד קוד
הגישה לג'ב היא בשלב "גישה מוקדמת" דרך הקונסולה של TypeSafe, שם מייצרים מפתח API. הקריאה היא POST https://api.typesafe.ai/v1/systemone, עם המודל jev-latest (שמצביע כרגע על גרסה 1.13.0).
פייתון:
# pip install typesafe-sdk   (המפתח במשתנה הסביבה TYPESAFE_API_KEY)
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={"document": "I was charged twice. Please fix this ASAP."},
        questions={
            "billing": Noul(instructions="Is this ticket about billing?"),
            "tone": Choice(
                instructions="What is the customer's tone?",
                criteria={"calm": None, "frustrated": None, "angry": None},
            ),
            "urgency": Score(
                instructions="How urgent is this ticket?",
                criteria=["can wait", "this week", "today"],
            ),
        },
    )

print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)
JavaScript / TypeScript (דורש Node 20 ומעלה):
// npm install @typesafe-ai/sdk
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();
const response = await client.systemOne({
  state: { document: "I was charged twice. Please fix this ASAP." },
  questions: {
    category: choice("What is this ticket about?", { billing: null, technical: null, other: null }),
  },
});

console.log(response.answers.category.choice);
הטיפוסים ב-TypeScript נגזרים אוטומטית מהשאלות שהגדרתם, כך שאם כתבתם שלוש אפשרויות, הקומפיילר יודע שהתשובה היא אחת משלושתן. זו הסיבה לשם החברה.
סקיל לקלוד קוד. TypeSafe פרסמה סקיל רשמי לסוכני קוד, והתקנה בקלוד קוד (Claude Code) היא שתי פקודות:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
אחרי ההתקנה אפשר לבקש מקלוד קוד "השתמש בסקיל של TypeSafe, עבור על הפרויקט ומצא איפה שיפוט חכם יחסוך קוד", והוא מציע נקודות שבהן תנאי if מסובך יכול להפוך לשאלה אחת. מי שעובד עם LangChain מקבל חבילה ייעודית, langchain-typesafe, עם מחלקה בשם TypeSafeClassifier, ו-LangChain עצמה מציגה שני שימושים: ניתוב משימות בין מודל זול למודל חזק לפי מורכבות, ושער בטיחות שבודק קריאות כלים מסוכנות של סוכן לפני שהן רצות.
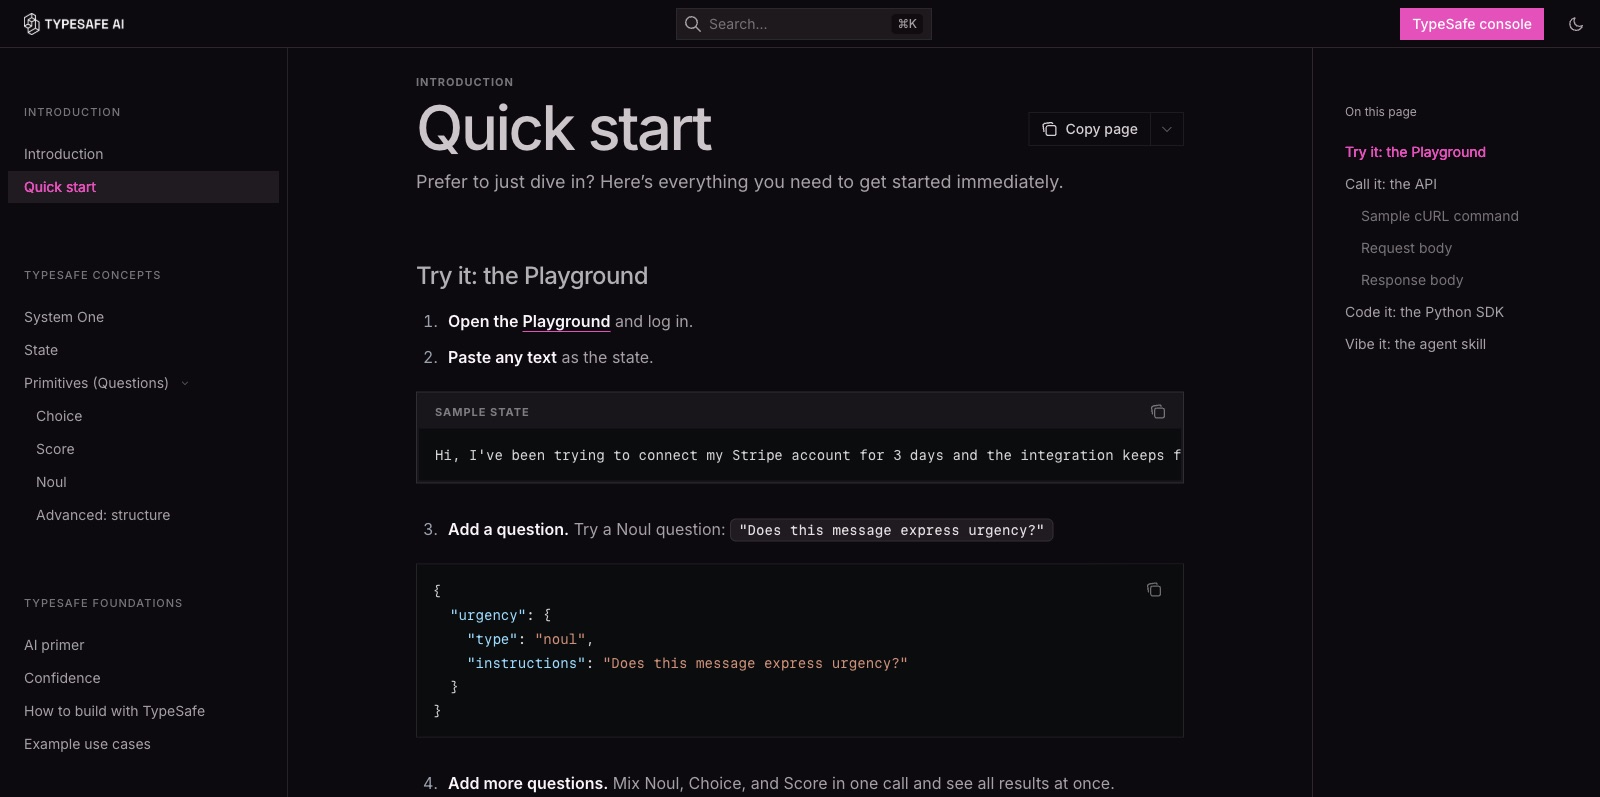 עמוד המדריך המהיר בתיעוד של TypeSafe, ספטמבר 2026. קרדיט: TypeSafe AI
איך בונים עם זה נכון: שמונה כללים מהתיעוד
הפילוסופיה של TypeSafe הפוכה לזו של הסוכנים האוטונומיים. במקום לשאול את ה-AI "מה לעשות עכשיו" ולתת לו לנהל את הלולאה, הקוד נשאר בשליטה, וה-AI מקבל שאלות צרות ומובנות. מתוך המדריך הרשמי, אלה הכללים שהכי משנים תוצאות:
- מה שקוד יכול לחשב, קוד מחשב. תנאים דטרמיניסטיים, ספירה, תאריכים, סכומים. ה-AI רק במקום שצריך שיפוט על טקסט לא מובנה.
- שולחים רק את מה שרלוונטי. הדיוק יורד ככל שהמצב מתמלא בפרטים שלא קשורים להחלטה. מסננים בקוד לפני ששולחים.
- מצביעים על שדות בשם. במקום "ההודעה האחרונה", כותבים
ticket.messages[0].text. פחות עמימות, יותר דיוק. - מפרקים שאלה רחבה לשאלות אטומיות. זה הכלל החשוב ביותר. במקום "האם זה ספאם?", שואלים חמש שאלות: האם מבקשים פרטי התחברות, האם מציעים פרס לא צפוי, האם יוצרים לחץ זמן, האם הדומיין של השולח לא תואם, האם הקישור מוסווה. וכל אות נחשף בנפרד.
- מכניסים מבנה לשאלות, לא לטקסט. ערכים שמגיעים מהקוד נשלחים כשדות, לא מודבקים לתוך משפט.
- שואלים הרבה במקביל. עשרות שאלות בקריאה אחת, בלי סבבים.
- משלבים תשובות בקוד. כללים או משקלים שאתם שולטים בהם, ולא "תחליט אתה".
- מנתבים לפי ביטחון. גבוה: פועלים. בינוני: אדם או מודל יקר. נמוך: תמיד אדם.
הדוגמה השלמה בתיעוד, טיפול בפניית שירות, מראה את זה מקצה לקצה: פניות סגורות מטופלות בקוד בלי שום קריאה ל-AI; לפנייה פתוחה נשלחות שבע שאלות במקביל (נושא, בקשת פרטי התחברות, אי-התאמת שולח, פרס לא צפוי, בקשת החזר, אזכור הזמנה, רמת תסכול); שלושה אותות ספאם משוקללים בקוד; ופנייה עם ביטחון נמוך בנושא עולה לאדם.
מה ג'ב לא יודע לעשות: הרשימה הכנה של TypeSafe עצמה
יש משהו מרענן בכך ש-TypeSafe מפרסמת עמוד תיעוד בשם "הקצוות המשוננים של ג'ב 1.13". זו רשימת החולשות של המודל, כפי שהחברה עצמה מנסחת אותה, ועבור מי ששוקל להכניס אותו לייצור היא חשובה יותר מכל בנצ'מרק:
- קריאה מילולית. המודל עונה על מה שכתבתם, לא על מה שהתכוונתם. שלילות, תנאים משתמעים ומילות היקף מתפרשות כלשונן. הפתרון: לכתוב את התנאי המדויק, ולפצל שאלה עמומה לשתי שאלות מילוליות.
- מספרים וספירה. הוא לא סופר באופן אמין, לא תווים, לא פריטים ולא מופעים של מילה. הוא מזהה "צורה של תשובה", לא סוכם. סופרים בקוד.
- תאריכים. הוא קורא תאריך כטקסט, לא ככמות מסודרת. איזה תאריך מוקדם יותר, כמה ימים בין שניהם, האם בתוך חלון: הכול לא אמין. מחלצים רכיבי תאריך כבחירה, ומחשבים בקוד.
- מצב גדול עם רעש. פרטים לא רלוונטיים מסיטים אותו. מסננים לפני.
- תוכן עוין. הוא לא מתייחס לנתונים כאל אויב כברירת מחדל. הוראות מוזרקות או ניסוח מגמתי יכולים להטות תשובה. בודקים היטב לפני פריסה רחבה.
- אי-עקביות מבנית. ההסתברות ל"כן" על שאלה, וההסתברות ל"לא" על השלילה שלה, לא בהכרח מסתכמות ל-1. לא בונים על זהויות חשבוניות בין שאלות נפרדות.
- ייצור טקסט. ג'ב 1.13 לא אומן לייצר טקסט, ולנסות לאלץ אותו דרך שרשרת בחירות זה איטי ולא יעיל.
ועוד שלוש מגבלות מעמוד המודלים: קלט טקסט בלבד (תמונות, אודיו ווידאו צריך להמיר לטקסט לפני), חלון של 64 אלף טוקנים לבקשה כשהמצב ועוד השאלה הארוכה ביותר לא עוברים 32 אלף, ואין כוונון (fine-tuning) פר חשבון: ההתאמה לתחום נעשית דרך מבנה הבקשה בלבד. מגבלות הקצב הן 250 אלף טוקנים בשנייה ו-1,200 בקשות בדקה, עם תוכניות ארגוניות שמעלות אותן ומציעות אפס שמירת נתונים.
ומה עם עברית?
התיעוד אומר במפורש: אנגלית היא שפת האימון העיקרית, ושפות אחרות, כולל כתבים לא לטיניים, עובדות בדיוק נמוך יותר. אין מספר לעברית. ההמלצה שלנו לעסק ישראלי: ההנחיות (instructions) ושמות האפשרויות באנגלית, המצב (הפנייה, המסמך) בעברית כפי שהוא, ומדידה של הדיוק על מאה מקרים אמיתיים מתויגים ידנית לפני שמכניסים לייצור. מי שרוצה ללמוד לעשות את זה צעד אחר צעד, יש לנו קורס אינטראקטיבי בעברית על ג'ב שבו בונים בדיוק את סט הבדיקה הזה.
מתי ג'ב, ומתי מודל שפה
הטבלה הזאת היא כל המדריך בקטן:
| המשימה | הכלי הנכון | למה |
|---|---|---|
| ניתוב אלפי פניות ביום למחלקות | ג'ב | אפשרויות ידועות מראש, נפח גבוה, מחיר של אלפית סנט |
| ניקוד מיליון ביקורות לפי מדיניות | ג'ב | סולם מדורג, פלט חינם, 20 דולר במקום אלפים |
| בדיקת בטיחות של תשובת צ'אטבוט לפני שהיא יוצאת | ג'ב | חצי שנייה, שאלות כן/לא על סיכונים, ניתוב לפי חומרה |
| בחירת כלי לסוכן AI מתוך 180 אפשרויות | ג'ב | ספר המתכונים של TypeSafe מדגים בדיוק את זה |
| סינון קטעים מהחיפוש לפני שמודל שפה עונה | ג'ב | ניקוד רלוונטיות במקביל, ואז מודל שפה על מה שנשאר |
| כתיבת תשובה ללקוח | מודל שפה | ג'ב לא כותב |
| סיכום מסמך, יצירת קוד, הסבר להחלטה | מודל שפה | פלט פתוח |
| ביקורת רגולטורית שדורשת נימוק כתוב | מודל שפה, או שניהם | ג'ב נותן מספר בלי הסבר |
| חישוב, ספירה, השוואת תאריכים | קוד רגיל | לא ג'ב ולא מודל שפה |
והתבנית הנכונה ברוב המערכות היא שילוב, לא החלפה: ג'ב עושה את הניתוב והסיווג המהירים, ומה שמסומן כלא בטוח עולה למודל שפה יקר או לאדם. TypeSafe עצמה מנסחת את זה כך: הכלים משלימים, ולא מתחרים. אם אתם מעמיקים בסוכני AI ואוטומציה, זו בדיוק השכבה שחסרה היום ברוב הפרויקטים: לא עוד סוכן שחושב, אלא שופט מהיר שאומר לסוכן מתי לעצור.
ומה זה אומר לעסק שלך
לפני שרצים לקונסולה, שלושה מבחנים של שתי דקות:
1. איפה אצלכם AI מקבל היום החלטה סגורה דרך טקסט חופשי? פנייה שמנותבת על ידי GPT שכותב "נראה לי שזה שירות לקוחות". תגובה ברשת שמסווגת כ"מעוניין" בפרומפט ארוך. מסמך שמקבל "ציון 7 מתוך 10". כל מקום כזה הוא מועמד: יש בו אפשרויות ידועות מראש, ואתם משלמים על פלט ומפרסרים אותו.
2. כמה מהמקרים האלה קורים ביום? מתחת לעשרות, ההבדל במחיר לא מורגש ומודל השפה שכבר יש לכם מספיק. מעל מאות, ובוודאי אלפים, המחיר והמהירות הופכים לטיעון עסקי. ובזמן אמת (צ'אט, משחק, בדיקה לפני שליחה) אין בכלל תחרות.
3. מה קורה כשהוא טועה? אם טעות עולה שיחת טלפון מיותרת, מכניסים אוטומציה מלאה. אם טעות עולה החזר כספי או תלונה רגולטורית, בונים את שלוש המדרגות: לפעול, לבדוק, לאדם. וזה בדיוק הדבר שג'ב מאפשר ומודל שפה לא: מספר כנה שאפשר לכתוב עליו מדיניות.
מי שכבר עובד עם קלוד קוד יכול להתקין את הסקיל של TypeSafe ולבקש ממנו למפות את הפרויקט. זו הדרך הזולה ביותר לגלות אם יש לכם בכלל בעיית System One.
שורה תחתונה
ג'ב הוא לא "עוד מודל". הוא טענה על איך צריכה להיראות תוכנה עם AI בפנים: קוד שמנהל, ומודל שעונה על שאלות סגורות, מהר, בזול, ועם מספר שאומר כמה לסמוך עליו. המספרים שהחברה מפרסמת מרשימים ועדיין לא אומתו מבחוץ, העברית עובדת בדיוק נמוך יותר, והמודל לא סופר, לא מחשב ולא כותב. אבל אם יש אצלכם החלטה סגורה שחוזרת אלפי פעמים ביום, זה הכלי הראשון שכדאי לבדוק מולו.
לכל המדריכים והקורסים שלנו על AI בארגון: ההטמעות שלנו וקורסי ה-AI האינטראקטיביים ב-9.90.
מקורות: פוסט ההשקה של TypeSafe · התיעוד: מודלים ומחירים · הקצוות המשוננים של ג'ב 1.13 · איך בונים עם System One · The Register על ההשקה · LangChain על ג'ב. כל המספרים נכונים ל-20.9.2026.
יעקב צדק, מרצה, יועץ ומטמיע AI בארגונים, ומוביל את קהילת Claude Code (קלוד קוד) הגדולה בישראל.
קורס במתנה עם ברכה אישית מכם, מסירה מיידית או בתאריך שתבחרו, וגישה לכל החיים.
קישורים רלוונטיים
שאלות נפוצות
יעקב צדק
מרצה AI מוביל בישראל, מטמיע בינה מלאכותית בארגונים מ-2021. מייסד LazySEO AI ומכללת צדק אקדמי, מוביל קהילות עם מעל 100,000 חברים. שותף רשמי של Meta, Google, Canva ו-TikTok.
עוד עליי ←