- ב-30 באוקטובר 2026 הודיעו OpenAI, גוגל ומיקרוסופט שיכבדו סימון משותף ב-robots.txt, __usage_ai-training, שמאפשר לבעלי אתרים להביע העדפה נגד אימון מודלי AI על התוכן שלהם. הטיוטה נכתבה בידי איש אנתרופיק ב-IETF. זו העדפה ולא חסימה טכנית, והיא עדיין לא תקן. מועדי הכניסה לתוקף, ההבדל בין אימון לעיגון (grounding), מה לשים ב-robots.txt היום, ומה זה אומר ל-GEO.
את הטיוטה הטכנית שעליה מבוסס הסימון המשותף כתב איש אנתרופיק, והיא הוגשה ל-IETF כטיוטה פרטית. בטיוטה עצמה כתוב במפורש שהיא לא אושרה על ידי ה-IETF ואין לה מעמד רשמי בתהליך התקינה.
עד היום, מי שרצה למנוע מחברות AI לאמן מודלים על האתר שלו, היה צריך להכיר כל סורק בשמו. GPTBot, Google-Extended, ClaudeBot ועוד שורה של שמות שמשתנים כל כמה חודשים. ב-30 באוקטובר הודיעו OpenAI, גוגל ומיקרוסופט שיכבדו שורה אחת משותפת, על בסיס טיוטה שכתב איש אנתרופיק. זה נשמע כמו כפתור "אל תיגעו בתוכן שלי". זה לא בדיוק זה.
בקצרה:
- מה הוכרז: סימון משותף ב-robots.txt בשם
__usage_ai-training, שבו בעל אתר מביע העדפה נגד שימוש בתוכן שלו לאימון מודלי AI.- מי: OpenAI, גוגל ומיקרוסופט פרסמו הודעות ב-30 באוקטובר 2026. הטיוטה הטכנית נכתבה בידי איש אנתרופיק.
- מתי: OpenAI "בחודשים הקרובים", מיקרוסופט מ-1 בפברואר 2027, גוגל "ב-2027". אנתרופיק, לפי מחבר הטיוטה, כבר התחילה ליישם.
- מה זה לא: לא חסימה טכנית ולא תקן מחייב. זו העדפה שהחברות התחייבו לכבד.
- ל-GEO: חסימת אימון היא לא חסימת ציטוט. אבל אצל גוגל ההשפעה על אפליקציות Gemini עדינה יותר, וכדאי להבין אותה לפני שמוסיפים שורה.
מה בדיוק הוכרז?
שלוש מהחברות הגדולות פרסמו ביום אחד שהן יכבדו את אותו סימון. OpenAI כתבה שהיא תכבד "סימון משותף" ב-robots.txt, הקובץ שבו אתרים מביעים העדפות לגבי השימוש בתוכן שלהם לאימון מודלי AI. גוגל פרסמה הודעה בבלוג של Google Search Central, ומיקרוסופט בבלוג של Bing.
הבסיס הוא טיוטה בשם Machine-Readable Training Preference Signal, שהוגשה ל-IETF (הגוף שמגדיר רבים מתקני האינטרנט) ב-30 באוקטובר. כתב אותה קווין קלי (Kevin Kelley) מאנתרופיק. היא נשענת על עבודת קבוצת העבודה AIPREF ב-IETF, שמגדירה אוצר מילים להעדפות AI.
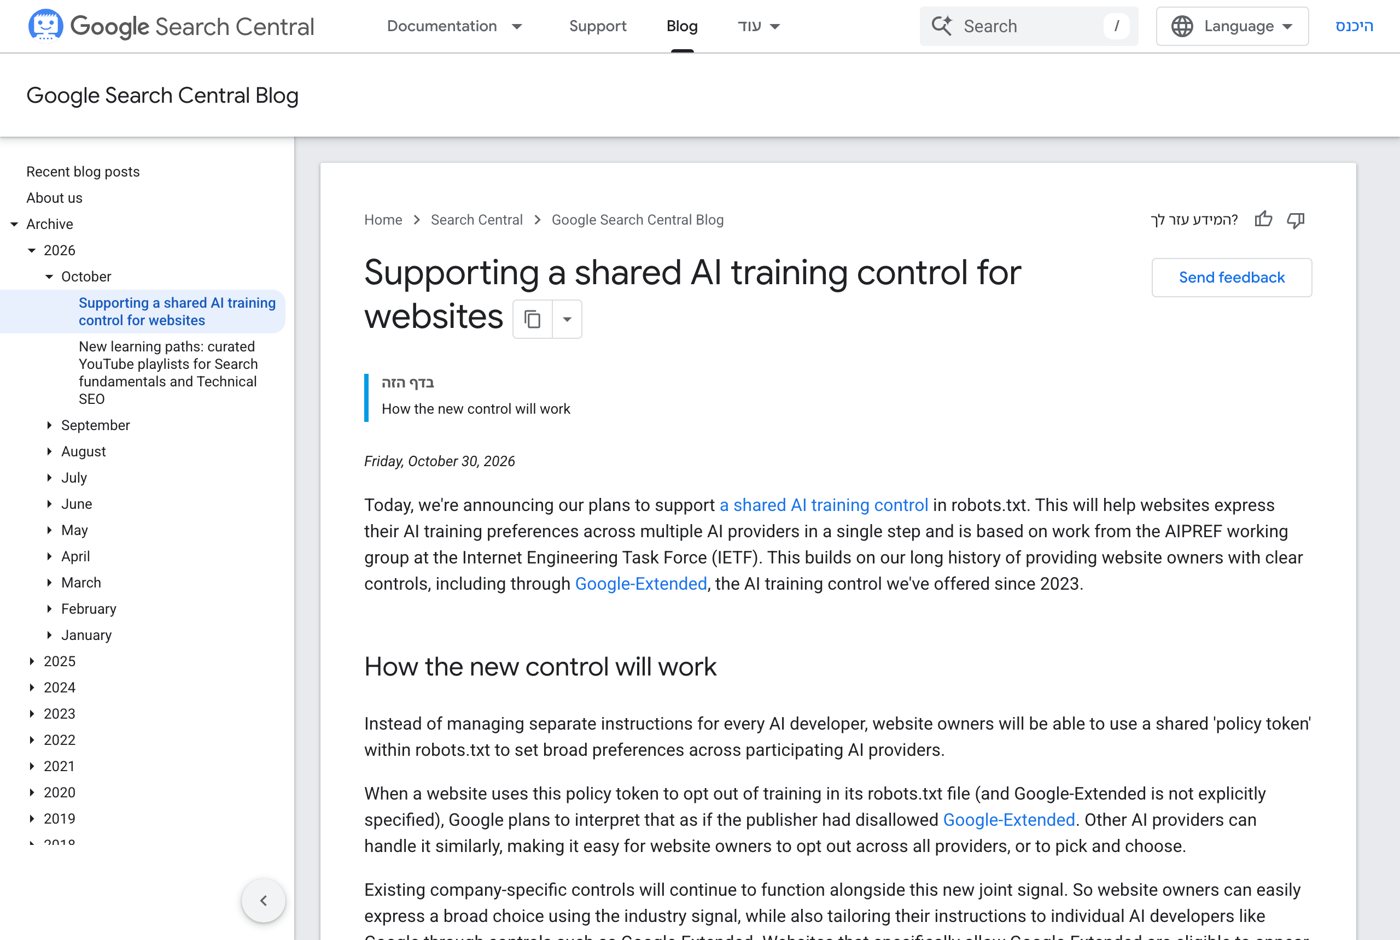 צילום מסך: ההודעה הרשמית בבלוג Google Search Central, 30 באוקטובר 2026
איך זה נראה בקובץ robots.txt?
הסימון נכתב כמו שם של סורק, אבל הוא לא סורק אמיתי. הוא "אסימון מדיניות" שכל החברות המשתתפות קוראות. כך נראית העדפה נגד אימון על כל האתר:
User-Agent: __usage_ai-training
Disallow: /
ואם רוצים לאפשר אימון רק על חלק מהאתר, למשל ערכת העיתונות, מוסיפים חריג. זו הדוגמה מתוך הטיוטה עצמה:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
אפשר גם להפך: לחסום רק תיקייה מסוימת, למשל Disallow: /premium/, ולהשאיר את השאר פתוח.
האם זה חוסם את ה-AI?
לא, וזה החלק שהכי קל לפספס. הטיוטה מגדירה את הסימון במפורש כהעדפה ולא כבקרת גישה, וכותבת שהוא "לא הוראה להתנהגות סריקה". כלומר, הסורקים עדיין יכולים להגיע לעמודים. מה שמשתנה הוא ההתחייבות של החברות לא להשתמש בתוכן לאימון.
עוד שני דברים חשובים:
- זה עדיין לא תקן. הטיוטה עצמה מציינת שהיא לא אושרה על ידי ה-IETF ואין לה מעמד רשמי בתהליך התקינה. גוגל כותבת שהיא תמשיך לעבוד עם השותפים כדי להפוך אותה לתקן.
- הסכמים פרטיים גוברים. לפי הטיוטה, הסכם בין אתר לחברת AI יכול לגבור על ההעדפה שבקובץ.
מי שרוצה למנוע גישה בפועל צריך חסימה טכנית, למשל בשרת או ב-CDN. robots.txt נשאר מה שהוא תמיד היה: בקשה מנומסת שהחברות הגדולות בוחרות לכבד.
מתי כל חברה מתחילה לכבד את הסימון?
כל חברה הודיעה על לוח זמנים משלה:
| חברה | מה הודיעה | מתי |
|---|---|---|
| OpenAI | תכבד את הסימון, והבקרות הקיימות ימשיכו לפעול | "בחודשים הקרובים" |
| מיקרוסופט | תכבד את ההעדפות לאימון ולעיגון בזמן הסריקה | מ-1 בפברואר 2027 |
| גוגל | תפרש את הסימון כחסימה של Google-Extended | "ב-2027" |
| אנתרופיק | מחבר הטיוטה כתב שהחברה כבר התחילה ליישם | לא פורסם מועד רשמי |
לגבי אנתרופיק חשוב לדייק: לא מצאנו הודעה רשמית נפרדת שלה. המידע מגיע מהמייל שבו מחבר הטיוטה הציג אותה ברשימת התפוצה של ה-IETF, כפי שדווח. במיקרוסופט יש עוד שני תאריכים: מ-1 במרץ 2027 התגיות NoArchive ו-NoCache לא ייקראו יותר כהעדפה לגבי אימון או עיגון, וההעדפות הזמניות לעיגון שאפשר להגדיר ב-Bing Webmaster Tools יפוגו ב-30 בספטמבר 2027.
אימון מול עיגון: למה חסימת אימון לא מוחקת אתכם מתשובות AI?
זה ההבדל הכי חשוב לכל מי שעוסק ב-GEO. מיקרוסופט מגדירה את שני המושגים בבירור:
- אימון (training): שימוש בתוכן כדי לשנות את הפרמטרים של המודל. התוכן הופך לחלק מ"הידע" של הגרסה הבאה.
- עיגון (grounding): שימוש בתוכן כקלט בזמן אמת, כדי לבסס את התשובה. זה המצב שבו ה-AI מצטט אתכם ומקשר אליכם.
הסימון המשותף עוסק באימון. ההופעה בתשובות, עם ציטוט וקישור, נשלטת ברוב המקרים במקום אחר:
- OpenAI: הבקרות הקיימות נשארות. GPTBot קשור לאימון, וההופעה בתשובות של ChatGPT Search תלויה ב-OAI-SearchBot. חסימת אימון לא אמורה להוציא אתכם מהחיפוש של ChatGPT.
- מיקרוסופט: יש בקרה נפרדת לעיגון, בתגית meta או בכותרת HTTP עבור Bingbot (
ai-grounding:disallow). לפי מיקרוסופט, ההעדפות לא משנות את הזכאות לתוצאות החיפוש הרגילות של Bing. - גוגל: כאן צריך לשים לב. גוגל תפרש את הסימון המשותף כאילו חסמתם את Google-Extended, אלא אם הגדרתם את Google-Extended במפורש. לפי התיעוד של גוגל, Google-Extended שולט גם באימון Gemini וגם בעיגון, ובהודעה החדשה גוגל כותבת שאתרים שמאפשרים במפורש את Google-Extended זכאים להופיע בתשובות ולקבל קליקים דרך עיגון באפליקציות Gemini. מצד שני, Google-Extended לא משפיע על ההופעה בחיפוש של גוגל ולא משמש כאות דירוג.
המשמעות המעשית: אתר שחוסם אימון דרך הסימון המשותף ורוצה להמשיך להופיע בתשובות של אפליקציות Gemini, צריך לשקול להגדיר את Google-Extended במפורש. זו החלטה עסקית, ולא טכנית.
מה לשים ב-robots.txt כבר היום?
הכול מתחיל בשאלה אחת: מה התוכן שלכם עושה בשבילכם?
אם התוכן הוא שיווק (בלוג, מדריכים, עמודי שירות), המטרה היא שה-AI יכיר אתכם ויצטט אתכם. ברוב המקרים אין סיבה לחסום משהו. זה בדיוק התחום של GEO, הופעה בתשובות של ChatGPT ושל מנועי ה-AI. הסברנו אותו בהרחבה במדריך GEO, ובמדריך איך גורמים ל-AI לצטט את האתר שלכם.
אם התוכן הוא המוצר (תוכן בתשלום, מאגר מקצועי, מחקר), יש היגיון להוסיף את הסימון כבר עכשיו. הוא לא יזיק, והוא ייכנס לתוקף בהדרגה אצל כל חברה. במקביל:
- השאירו את הבקרות הקיימות. כל החברות כתבו שהבקרות הנפרדות (GPTBot, Google-Extended ואחרות) ממשיכות לפעול.
- הפרידו בין תיקיות. חסמו אימון רק על מה שבאמת שווה כסף, והשאירו פתוחים עמודי שיווק וערכת עיתונות.
- בדקו את גוגל בנפרד. החליטו אם אתם רוצים להופיע באפליקציות Gemini, והגדירו את Google-Extended בהתאם.
- בדקו את Bing. מי שמשתמש היום ב-NoArchive או NoCache כדי להגביל AI, צריך לעבור לבקרות החדשות עד 1 במרץ 2027.
- תעדו את ההחלטה. החלטה על שימוש בתוכן לאימון AI היא החלטה של ההנהלה, לא רק של מי שמתחזק את האתר.
אם אתם לא בטוחים, אל תחסמו בלי לבדוק. חסימה שגויה של הסורק הלא נכון יכולה לעלות לכם בנראות, בדיוק בערוץ שגדל הכי מהר. אם אתם רוצים שמישהו יבנה את האסטרטגיה הזאת איתכם, זה חלק מהעבודה בשירות ה-GEO.
הסיפורים המשלימים מהיום: פיקה השיקה מודל וידאו חדש עם סאונד ומשקלים פתוחים, ומטא בוחנת בשקט סטייליסט AI שבונה ארון בגדים מהתמונות באינסטגרם. שני הסיפורים, כמו הסיפור הזה, עוסקים באותה שאלה: מה ה-AI עושה עם התוכן שכבר פרסמנו.
השורה התחתונה
לראשונה, בעלי אתרים יקבלו שפה אחת לומר לכמה חברות AI "לא לאמן על התוכן שלי". זה צעד משמעותי, אבל הוא העדפה, לא חומה, והוא נכנס לתוקף בהדרגה עד 2027. ההחלטה החשובה באמת היא לא אם להוסיף את השורה, אלא אם אתם רוצים שה-AI ילמד מכם, יצטט אתכם, או שניהם.
רוצים לבנות את האתר והכלים בעצמכם, בלי לחכות למתכנת?
שינוי ב-robots.txt, בדיקת תגיות, סקריפט שבודק אילו סורקים מגיעים לאתר: כל אלה משימות שאפשר לעשות לבד, כשיודעים לעבוד עם הכלים הנכונים. בחבילת סוכני ה-AI נמצא קורס קלוד קוד (Claude Code), שבו לומדים לבנות ולתחזק מערכות לעסק בעברית ובלי רקע בתכנות, יחד עם קורס גרוק בוט (Grok Bot), וקורס סושיאל פלואו (SocialFlow) במתנה. 297 ₪ + מע"מ במקום 594, עד 12.11, עם 16 שיעורים פתוחים לצפייה בחינם.
מקורות:
- OpenAI: Making it easier for websites to express AI training preferences (30.10.2026)
- Google Search Central: Supporting a shared AI training control for websites (30.10.2026)
- Microsoft Bing: Your content, your choice: clearer preferences for training and grounding (30.10.2026)
- IETF: Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal)
- Google: התיעוד של Google-Extended
קורס במתנה עם ברכה אישית מכם, מסירה מיידית או בתאריך שתבחרו, וגישה לכל החיים.
קישורים רלוונטיים
שאלות נפוצות
יעקב צדק
מרצה AI מוביל בישראל, מטמיע בינה מלאכותית בארגונים מ-2021. מייסד LazySEO AI ומכללת צדק אקדמי, מוביל קהילות עם מעל 100,000 חברים. שותף רשמי של Meta, Google, Canva ו-TikTok.
עוד עליי ←